

Hai provato sulla tua pelle il fastidio provocato da una sbagliata preparazione dei dati? Vuoi evitare di perdere tempo a causa di problemi con i dati proprio nel mezzo del flusso creativo del tuo modello? In questo articolo, esploreremo come strutturare un’Analisi Esplorativa dei Dati (EDA) efficace che spiani la strada per i passaggi successivi.
Nota: l’articolo è diviso in due parti (Parte 1 e Parte 2) e questa è la seconda parte.
Conoscenze preliminari
Cos’è l’Analisi Dati Esplorativa (EDA)
L’Analisi Esplorativa dei Dati (EDA) è un passo cruciale nella fase iniziale di qualsiasi progetto di data science o machine learning. Consiste nell’esaminare e comprendere i dati per identificare pattern, tendenze e relazioni che possono guidare l’analisi e la modellazione dei dati. In questa fase il data scientist è come uno chef che studia gli ingredienti a disposizione per scegliere la ricetta da cucinare. Nella prima parte abbiamo visto i primi 4 step, ora ci concentreremo sui rimanenti.
5. Analisi Multivariata: la correlazione
Siamo giunti a una fase fondamentale dell’EDA, l’analisi della correlazione.
Questa consiste nel comprendere le relazioni tra le diverse variabili nel dataset, ovvero come tendono a variare l’una rispetto all’altra.
La correlazione può essere positiva (entrambe aumentano o diminuiscono insieme), negativa (una aumenta mentre l’altra diminuisce) o nulla (nessuna relazione evidente). Attento però, Correlation is not Causation, ovvero la correlazione non implica causalità. Se due variabili A e B sono positivamente correlate non possiamo dire che se A aumenta allora B aumenta. Confondere i due concetti può portare a conclusioni sbagliate e a volte assurde, come comprare delle scarpe più grandi a tuo figlio credendo di migliorare le sue capacità di lettura. Non sai di cosa stiamo parlando? continua a leggere.
Correlation is not Causation
Abbiamo preso un gruppo di bambini e abbiamo segnato per ognuno di loro la taglia delle scarpe e la loro capacità di lettura. Abbiamo scoperto che c’è una forte correlazione tra le due variabili, ovvero i bambini con scarpe più grandi sono anche più bravi a leggere.
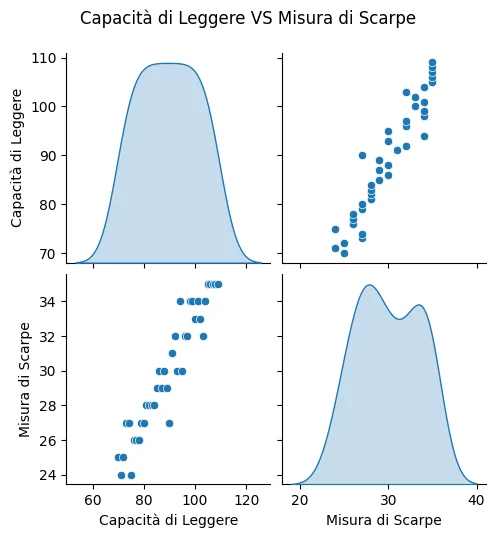
Ma quindi possiamo dire che basta comprare al figlio delle scarpe più grandi per migliorare la sua capacità di lettura? Ovviamente no, la correlazione è dovuta al fatto che i bambini più grandi hanno scarpe più grandi e sono anche più bravi a leggere. In questo caso abbiamo a che fare con una correlazione spuria, ovvero una correlazione che non ha senso, generata da una terza variabile (l’età) detta variabile confondente o confounder. Ti consigliamo di leggere questo articolo per approfondire il tema.
Perché è Importante studiare la correlazione
Delle features sono correlate quando ad un aumento di una, corrisponde un aumento (o diminuzione) dell’altra. Questo significa che le informazioni fornite sono molto simili e poco utili al modello. Addirittura quando il numero di features correlate è grande, la capacità del modello viene ridotta notevolmente, causando instabilità e perdita di generalizzazione. La motivazione alla base di ciò non è banale ed è riconducibile al fenomeno dell’overfitting. Spiegato in parole (molto) povere, il modello impara ‘troppo bene’ i dati di allenamento e quando si trova davanti a dei dati nuovi leggermente diversi non sa bene come comportarsi.
Un altro effetto negativo dell’usare features inutili è l’aumento della complessità computazionale del processo di apprendimento.
Analisi Grafica
Un metodo molto usato per visualizzare graficamente la distribuzione relativa di diverse features è il pairplot. Questo ci permette di visualizzare le relazioni tra le variabili in un unico grafico, facilitando la comprensione delle relazioni tra le variabili.
Questo passaggio grafico è molto importante perchè consente di capire se la correlazione tra le variabili è lineare o no. In base al tipo di correlazione possiamo scegliere il metodo più adatto per calcolarla.
Il pairplot riporta riporta su entrambi gli assi le variabili del nostro dataset e ogni cella corrisponde ad una combinazione di queste. Sulla diagonale abbiamo quindi la variabile rispetto a se stessa e la cella mostra la sua distribuzione. In ogni altra cella abbiamo la distribuzione relativa delle due variabili in X e Y della cella stessa, rappresentata tramite scatterplot . Questo è molto utile per un’investigazione visiva della correlazione.
Nel nostro caso non appaiono evidenti correlazioni, ma per avere una conferma possiamo calcolare il coefficiente di correlazione, che ci da una misura quantitativa di quest’ultima.
Calcolo della Correlazione
Il coefficiente di correlazione ci fornisce un’indicazione della forza e della direzione della relazione, attribuendole un valore tra -1 (negativa) e 1 (positiva).
Per capire se tale valore ha significatività statistica possiamo guardare al p-value.
Esistono diverse tipologie di coefficiente di correlazione (Spearman, Pearson, Kendall), ciascuno dei quali è indicato in specifiche circostanze.
Nel nostro esempio utilizziamo il coefficiente di correlazione di Pearson per misurare la relazione lineare tra due variabili continue, implementato direttamente nella metodo corr() del Pandas Data Frame.
Nota che se, come nel nostro caso si evince dal pairplot, la relazione tra le variabili non è lineare, il coefficiente di correlazione di Pearson non è il metodo più appropriato per quantitficare precisamente la correlazione. Vuoi capire perchè? Abbiamo un articolo apposta per questo.
Valori più vicini a 1 indicano una forte correlazione positiva, mentre valori più vicini a -1 indicano una forte correlazione negativa. Valori vicini a 0 indicano una correlazione debole o assente.
L’heatmap ci consente di dare una rappresentazione qualitativa all’indice di correlazione. Grazie a questo possiamo notare la presenza di una moderata correlazione negativa tra le variabili ‘Pclass’ e ‘Fare’, che poteva non essere così evidente dal pairplot. Nelle fasi successive del flusso, in particolare durante il feature engineering decideremo come agire su queste due variabili.
6. Visualizzazione dei Dati
Nelle sezioni precedenti, abbiamo visto alcune tecniche di visualizzazione e compreso come queste possano agevolare di molto l’analisi. Ad esempio, abbiamo utilizzato l’istogramma per esplorare la distribuzione di una variabile numerica e il pairplot per visualizzare le relazioni tra le variabili.
Tuttavia esistono molte altre tecniche di visualizzazione, ciascuna che si adatta a uno specifico scopo e/o tipo di dato. Se vuoi approfondire il tema ti consigliamo di leggere l’articolo che abbiamo scritto dedicato alla visualizzazione dei dati.
7. Individuazione degli Outliers: Identificare i Dati Anomali
Gli outliers sono punti di dati che si discostano significativamente dalla maggior parte degli altri punti nel dataset. Possono essere il risultato di errori di misurazione, anomalie reali nei dati o eventi eccezionali.
Perché è Importante
Gli outliers possono influenzare negativamente le analisi statistiche, distorcendo le stime dei parametri e riducendo l’efficacia dei modelli. Si pensi ad esempio al semplice calcolo della media tra questi due insiemi di dati:
- [1, 2, 3, 4, 5, 100] = 19.2
- [1, 2, 3, 4, 5, 6] = 3.5
I due insieme rappresentano lo stesso fenomeno, tuttavia nel primo, magari a causa di un errore di misurazione, l’outlier 100 ha distorso la media. Questo è solo un esempio, ma i modelli di machine learning possono essere influenzati in modo simile nel computo dei loro parametri.
Per sfruttare un boxplot nella ricerca degli outliers, osserva i punti al di fuori dei “whiskers” (baffi) del boxplot. Gli outliers sono rappresentati da punti isolati a destra (per i valori superiori) o a sinistra (per i valori inferiori) dei baffi. Questi punti indicano valori estremi che possono essere considerati anomalie nel dataset. Nel nostro caso abbiamo molti valori estremi superiori.
Come Trattare gli Outliers
Esistono diversi approcci per trattare gli outliers:
Rimozione degli Outliers: Rimuovere gli outliers se sono il risultato di errori di misurazione o se influenzano negativamente l’analisi.
Trasformazione dei Dati: Trasformare i dati utilizzando tecniche come la log-trasformazione o la radice quadrata per ridurre l’effetto degli outliers.
Utilizzo di Modelli Robusti: Utilizzare modelli robusti che sono meno sensibili agli outliers, come la regressione robusta o gli algoritmi di machine learning robusti.
La spiegazione di queste tecniche non è banale e richiede un articolo a parte, che sarà presto disponibile a questo link.
Nel nostro esempio rimuoveremo gli outliers utilizzando il metodo IQR (Interquartile Range).
Questo codice Python utilizza il metodo IQR per identificare e rimuovere gli outliers nella variabile ‘Fare’ nel dataset Titanic. In questo metodo, gli outliers sono definiti come valori al di fuori dell’intervallo [Q1 – 1.5 * IQR, Q3 + 1.5 * IQR]. L’IQR (Interquartile Range) è la differenza tra il primo e il terzo quartile dei dati.
Our Suggestion
There is a library called `pyod` (Python Outlier Detection) that provides a wide range of techniques for detecting outliers in data. It is worth exploring this library to see if it can provide a more robust and automated approach to outlier detection. We plan to bring an article on this topic in the future, in the meantime this is their official documentation.
8. Composizione delle Classi
Se hai a che fare con un problema di classificazione, è importante esaminare la composizione delle classi nel dataset. In molti dataset reali, le classi possono essere sbilanciate, ovvero una classe può essere sovrarappresentata rispetto alle altre. Ad esempio nel dataset Titanic, la classe “sopravvissuti” potrebbe essere molto più piccola rispetto alla classe “non sopravvissuti”.
Perché è Importante
La composizione delle classi può influenzare la capacità del modello di apprendere e generalizzare correttamente. In presenza di classi sbilanciate, il modello può essere incline a predire la classe maggioritaria, ignorando la classe minoritaria. Questo può portare a previsioni distorte e a una scarsa capacità del modello di generalizzare su nuovi dati.
In questo caso come ci aspettavamo la classe dei sopravvissuti e più piccola rispetto a quella dei non sopravvissuti. In questa fase non prederemo alcuna decisione e delegheremo tutto alla parte di feature engineering. Tuttavia è importante essere consci di questo fatto per poi agire di conseguenza. Ad esempio potremmo provare preparare un dataset di allenamento sbilanciato e uno bilanciato, usato opportune tecniche di ribilanciamento (oversampling e undersampling). A questo punto allenare un modello per ognuno e poi indagare le capacità di generalizzazione (predire correttamente nuovi dati) dei due modelli per individuare il migliore.
Fine parte 2 – Riepilogo step
Arriviamo alla fine dell’analisi esplorativa dei dati. Ricorda, ciò che abbiamo visto è un’ottima base ma va adattata al contesto specifico della tua analisi. Ci sono situazioni che richiedono analisi più dettagliate o nuovi approcci, come i dati temporali nel settore finanziario.
Se hai suggerimenti o feedback siamo felici di riceverli nei commenti o tramite il form di contatto.
- Caricare il Dataset
- Investigare la Struttura
- Gestione dei Missing Values
- Analisi Univariata
Parte 2:
- Analisi della Correlazione
- Gestione Outliers
- Analisi Composizione Classi (in problemi di classificazione)
Hai finito !100
Hai concluso la seconda e ultima parte!
Ora sei pronto per svolgere la tua EDA.
Se non hai letto la prima parte la trovi cliccando qui.


