

Hai sentito parlare di train, test e validation data e vuoi scoprire cosa sono? Già li conosci ma hai dei dubbi riguardo a quando ciascun set va impiegato? In questo articolo cerchiamo di chiarire in modo semplice la differenza tra questi dati, focalizzandoci sull’importanza di distinguere tra validation e test data, un errore spesso commesso anche da chi ha già esperienza nel settore.
Conoscenze preliminari
Distinzione Intuitiva
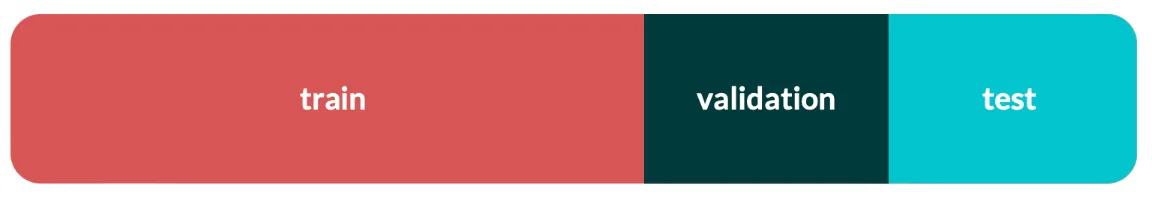
Immagina di essere uno studente particolarmente fortunato: hai tra le mani una lista di possibili domande per l’esame imminente, ognuna con la risposta corretta. In un colpo di genio, decidi di dividere questa lista: 15 domande le usi per lo studio mentre le altre 5 le lasci da parte per il momento.
Le 15 domande che hai deciso di studiare rappresentano il tuo training set, l’insieme su cui ti concentrerai per prepararti all’esame. Dopo 5 giorni intensi di studio, sei sicuro di conoscere tutte le risposte a quelle domande. Ma sei davvero pronto per l’esame?
Per scoprirlo, non puoi fare affidamento solo sulle domande che hai studiato, perché ovviamente le conosci già bene e rischieresti di sovrastimare il tuo reale livello. Ecco perché entrano in gioco le 5 domande che hai lasciato da parte: il tuo validation set. Rispondendo a queste domande e confrontando le tue risposte con le soluzioni corrette puoi individuare gli argomenti su cui devi ancora concentrarti per migliorare le tue conoscenze.
Ma la vera verifica finale necessita di ulteriori domande, perché il validation set presenta ora lo stesso problema del training set. Il set di domande che ci serve è l’esame stesso, il test set. Qui ottieni una valutazione finale, che ti darà un’indicazione affidabile sul tuo livello di preparazione e sulle competenze acquisite durante lo studio.
Training Set
Il training set è il campione di dati utilizzato per addestrare il modello. È il set di dati effettivo che il modello utilizza per apprendere e aggiustare i suoi parametri, come i pesi e i bias in una rete neurale.
Scopo
Il suo scopo è quello di consentire al modello di imparare le relazioni complesse tra gli input e gli output desiderati.
Caratteristiche
Un buon training set dovrebbe essere:
- Rappresentativo: deve rappresentare i dati reali su cui il modello verrà poi usato. In caso contrario il modello imparerà relazioni che non ci servono veramente. La scelta del dataset deve prendere in considerazione questo aspetto.
- Bilanciato: i valori che il modello deve imparare a prevedere dovrebbe essere presenti in simil numero, così da permettere al modello di imparare efficacemente le relazioni tra le features e l’output. In caso di dati sbilanciati si possono sfruttare le tecniche di undersampling e oversampling.
- Pulito: deve contenere meno impurità possibili, come missing values, errori e outliers. In questo caso un’accurata analisi esplorativa dei dati (EDA) è fondamentale. Vuoi saperne di più? Clicca qui.
Validation Set
Il validation set è il campione di dati utilizzato per valutare il modello mentre si regolano gli iperparametri e si ottimizzano le prestazioni.
Nell’articolo sul supervised machine learning abbiamo visto che i modelli hanno dei parametri nella propria formula, i quali vengono modificati durante l’allenamento consentendo l’apprendimento dei dati. Un esempio di parametri sono β0 e β1 nel caso della linear regression del nostro articolo (formula riportata sotto).
Gli iperparametri sono invece tutti quei valori regolabili che non fanno parte della formulazione del modello in senso stretto. Un esempio di iperparametro è il learning rate, fondamentale nel processo di ottimizzazione dei parametri durante l’allenamento.
Scopo
Gli iperparametri di un modello vengono scelti prima dell’inizio dell’addestramento e quindi “incontrano” il training set. Lo scopo del validation set è quello di evitare sovrastime (upward biases) nelle performance causate dall’eccessivo adattamento del modello ai dati di training (overfitting). Il validation set consente valutare correttamente diverse versioni del modello, ciascuna con i propri iperparametri.
Caratteristiche
Il validation set eredita le caratteristiche del training set con un’aggiunta:
- Indipendenza: deve essere assolutamente indipendente dal training set e non deve intervenire direttamente nella fase di addestramento. Deve essere utilizzato solo per valutare e ottimizzare il modello, regolandone gli iperparametri.
Test Set
Il test set è il campione di dati utilizzato per fornire una valutazione imparziale di un modello una volta completato l’addestramento e la messa a punto.
Scopo
Il suo scopo è quello di fornire la valutazione più accurata possibile delle performance del modello. Può essere anche usato per comparare diversi modelli, ciascuno dei quali è prima passato attraverso il processo di allenamento (training) e validazione (validation).
Caratteristiche
Come per il validation set, eredita le caratteristiche del training set e richiede:
- Indipendenza: deve essere indipendente sia dal validation che dal training set. Deve essere utilizzato solo una volta che il modello è completamente addestrato e ottimizzato, per valutare le sue prestazioni finali e garantire una valutazione imparziale.
Dimensionamento dei Set
Dopo aver esplorato il significato di ciascun insieme vediamo a livello pratico come suddividere il dataset iniziale nei tre set e dimensionarli opportunamente.
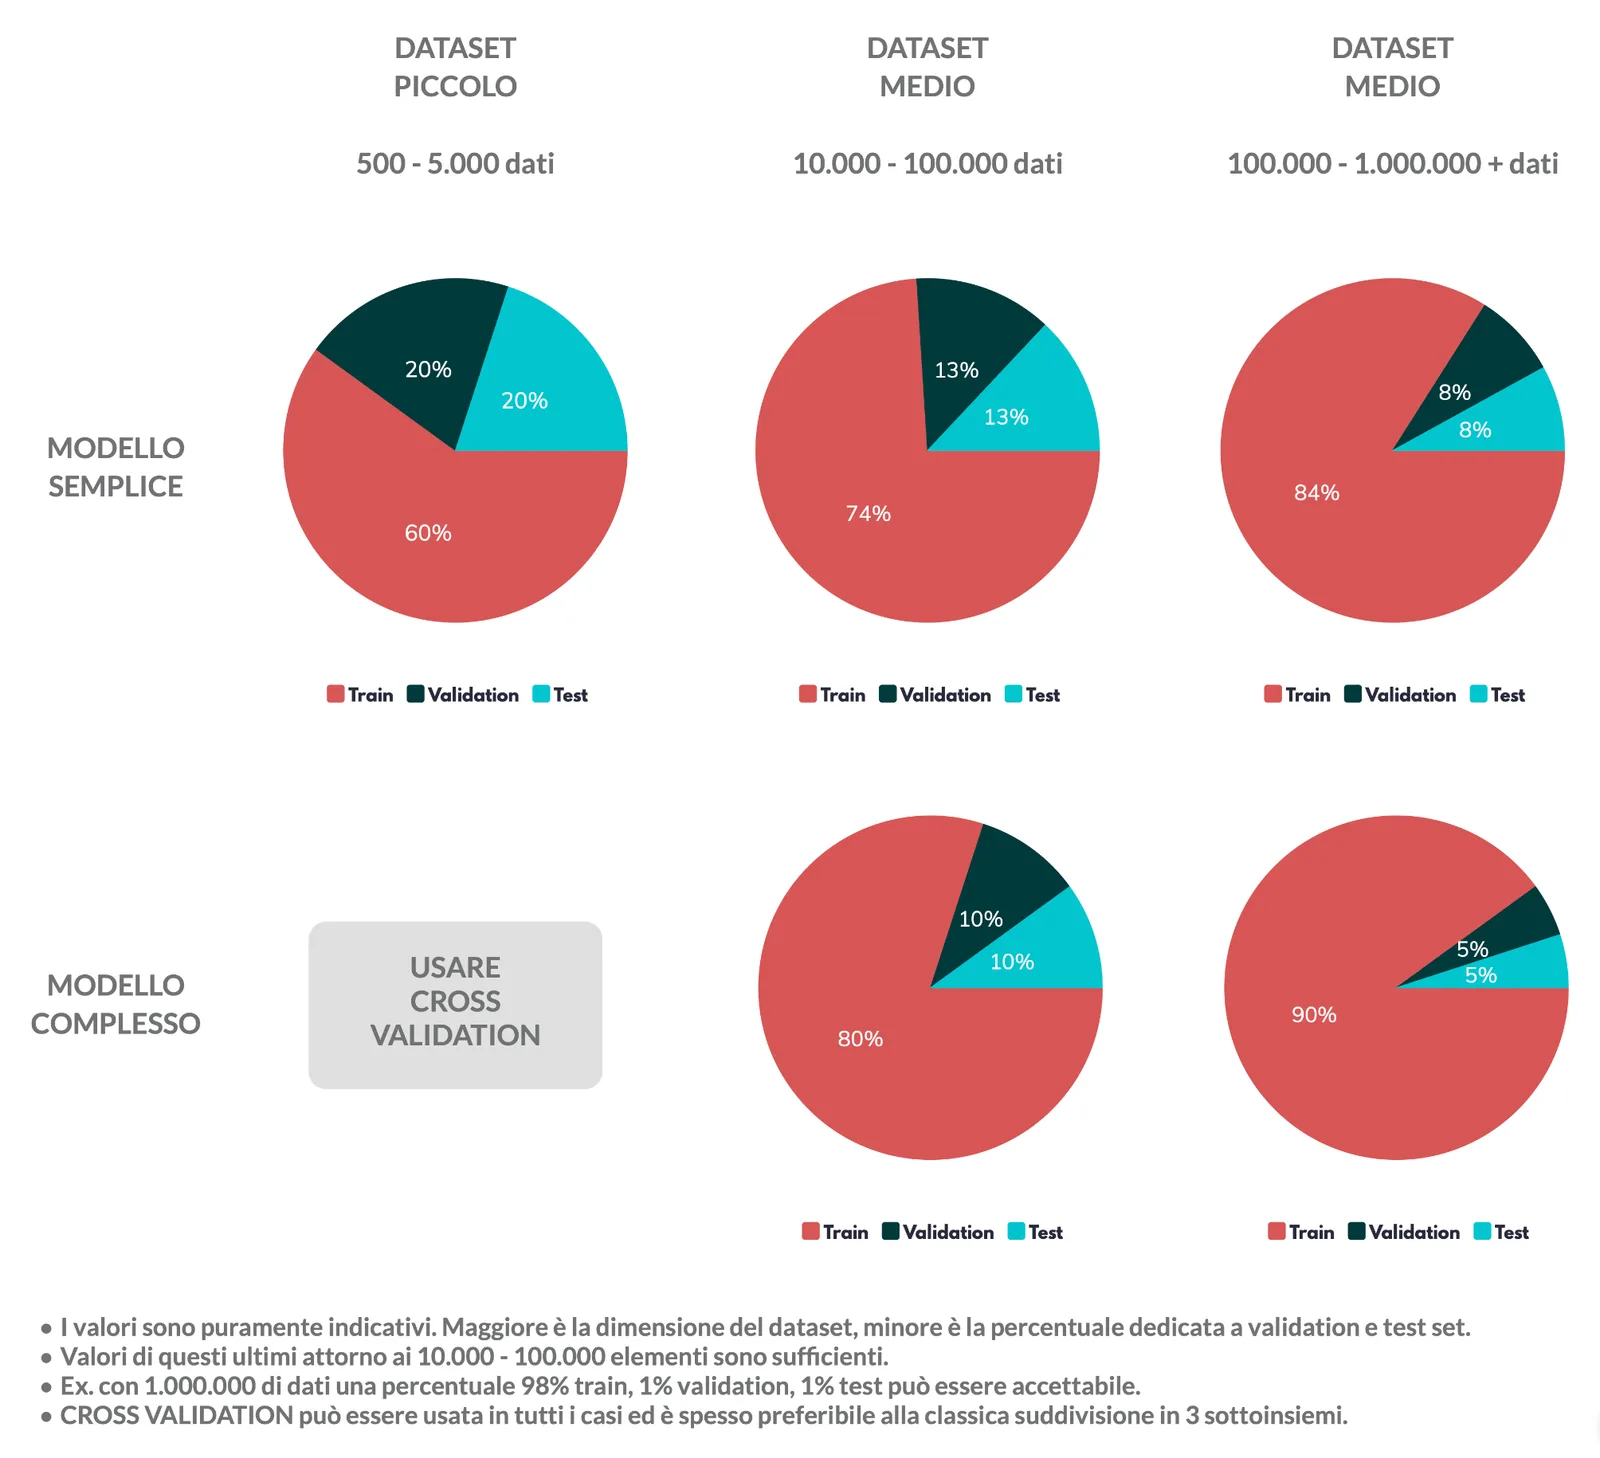
Il dimensionamento dei tre insiemi non è banale. Un training set troppo piccolo rappresenterebbe una base di conoscenza insufficiente per consentire al modello di imparare relazioni complesse tra input e output. Allo stesso tempo un training set troppo grande lascerebbe poco spazio agli altri due set, impedendo una valutazione affidabile delle performance. Si tratta quindi di raggiungere un compromesso.
La scelta dipende da due elementi: la dimensione totale del dataset e la complessità del modello che si vuole allenare. Non esiste una regola universale per il dimensionamento ma delle linee guida sono indicate in figura.
Codice Python
Il notebook qui sotto mostra come suddividere praticamente i dati, usando Python e la libreria Scikit-Learn. Come sempre, il notebook è disponibile al download a fine articolo.
Flusso Completo
Hai ancora dubbi sulle fasi in cui usare ciascun set? Questa sezione mira a chiarirli definitivamente.
Poniamoci in un caso in cui dobbiamo scegliere il migliore in assoluto tra due modelli, ciascuno con i propri iperparametri. Allora il flusso è descritto dalla seguente immagine.
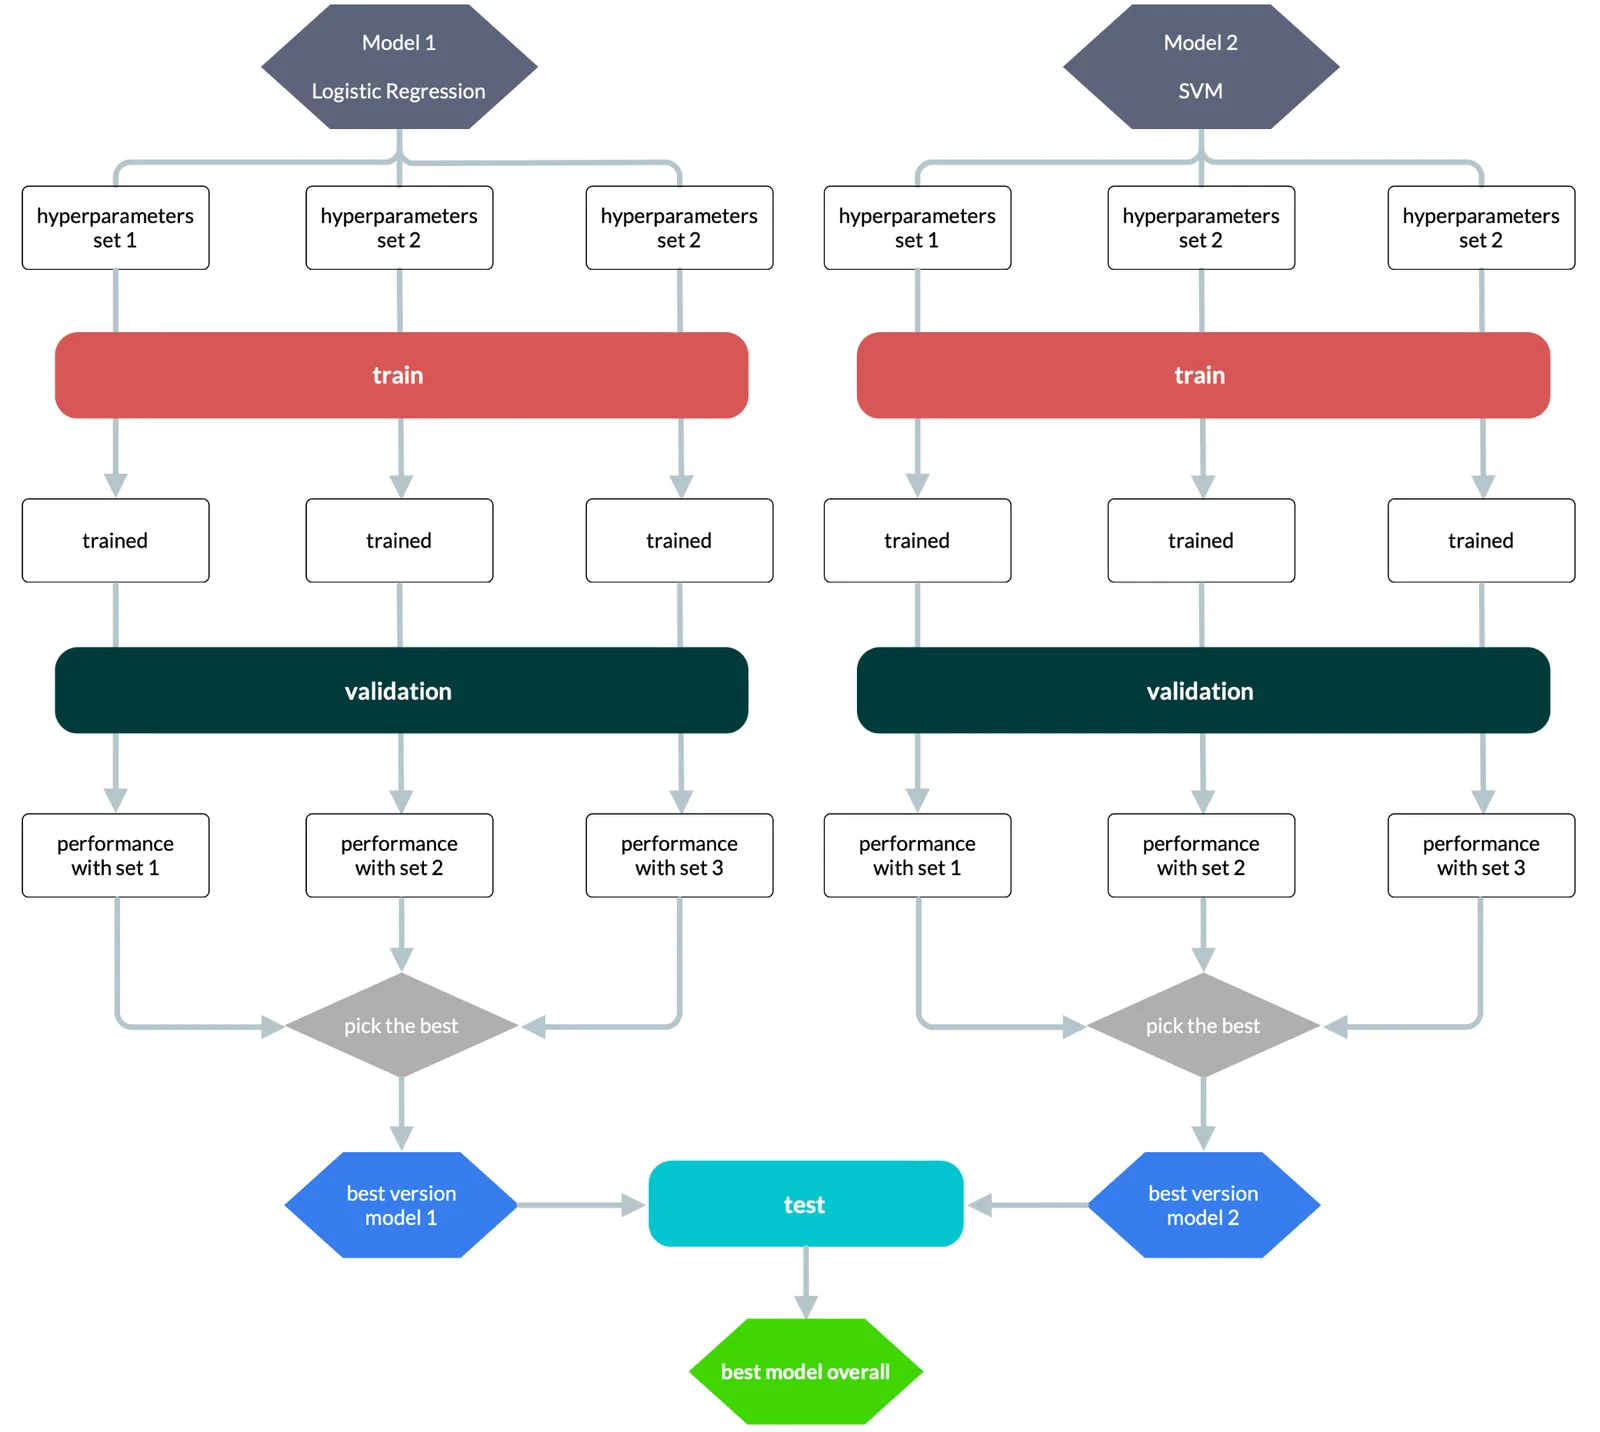
Riassumendo, scegliamo i due modelli e per ciascuno diverse combinazioni degli iperparametri. Ognuno viene allenato sul training set e successivamente valutato sul validation. Per ciascun modello viene selezionata la miglior versione e solo le due migliori versioni vengono confrontate sul test set per selezionare il vincitore.
K-fold Cross Validation
L’approccio di suddivisione dei dati che abbiamo visto, basato sulla divisione del dataset in 3 sottoinsiemi ha purtroppo un grosso limite, la tendenza a sottostimare le reali capacità di un modello. Questo è dovuto al fatto che i dati di allenamento vengono ridotti di dimensione per fare spazio agli altri due insiemi (validation e test). Detto in parole povere, stiamo togliendo conoscenza al nostro modello, che quindi faticherà a esprimere tutte le sue potenzialità.
Questo problema viene ingigantito quando abbiamo a che fare con dataset molto piccoli e modelli complessi. In questo caso dobbiamo cercare di lasciare più conoscenza possibile a disposizione del modello, in caso contrario l’allenamento non darebbe risultati sufficienti. La soluzione è rappresentata dalla Cross Validation. Vuoi sapere come funziona? Abbiamo preparato un articolo apposta.
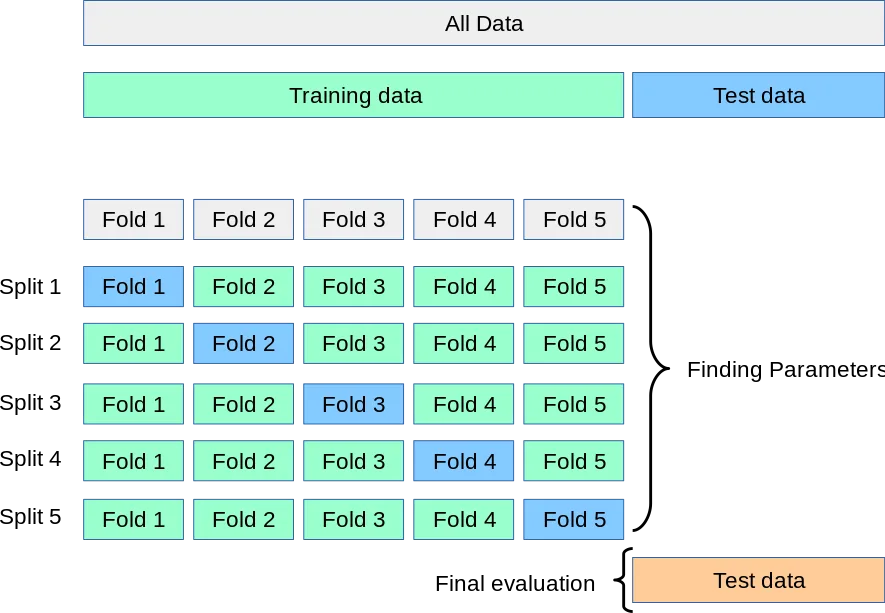
Image from Scikit-Learn


