
Hai sentito parlare di “Intelligenza Artificiale“ e “modello di Machine Learning” e stai cercando di capire cosa sono e come funzionano? Conosci a grandi linee il ragionamento che c’è dietro ma non riesci a capire come avviene la magia a livello pratico? Con questo articolo proviamo a dare risposta a queste domande.
Conoscenze preliminari
Questo articolo è un introduzione concettuale al Supervised Machine Learning e non richiede alcuna conoscenza preliminare. Durante la lettura, troverai utili riferimenti ad altri articoli per approfondire specifici concetti.
Premessa
I termini Intelligenza Artificiale (AI) e Machine Learning (ML) sebbene molto spesso usati in modo interscambiabile, indicano concetti diversi. Mentre l’AI è un campo generale che si occupa di creare sistemi che possono simulare l’intelligenza umana, Machine Learning e Deep Learning (DL) costituiscono un insieme di tecniche usate per raggiungere l’obiettivo.
Il Machine Learning si suddivide in Supervised Learning, Unsupervised Learning e Reinforcement Learning. Se vuoi capirne di più ne abbiamo parlato in questo articolo.
A sua volta il Supervised Machine Learning si suddivide in due categorie a seconda dei valori che possono essere assunti dalla variabile in uscita ‘Y’.
Regressione: è usata quando si vogliono prevedere valori numerici continui, quindi ‘Y’ è una variabile continua. Ad esempio un algoritmo di regressione può essere quello che prevede il peso di un bambino in base alla sua età e al suo sesso.
Classificazione: è usata quando si vogliono prevedere valori discreti (categorie). Ad esempio quando si vuole prevedere se un paziente ha una malattia {sì o no} in base ai suoi sintomi.
In entrambi i casi l’approccio e gli step necessari sono gli stessi, con l’unica differenza, appunto, della variabile predetta.

In questo articolo andiamo ad affrontare i tratti comuni alla maggior parte dei modelli di classificazione nel Supervised Learning, ricordati però che eccezioni a quello che stai per vedere possono essere presenti.
Iniziamo con un esempio pratico
Sei uno studente universitario molto meticoloso e tieni traccia del numero di ore che impieghi nella preparazione di un esame. Vorresti sapere se le ore che hai studiato finora sarebbero sufficienti per superarlo? Vediamo insieme come allenare un modello di Machine Learning che possa aiutarti a capirlo.
Per farlo abbiamo bisogno di due ingredienti principali:
Il Dataset
Il dataset è una parte fondamentale del Machine Learning perché costituisce la conoscenza del modello. Più i dati sono completi e chiari, maggiore sarà la probabilità che il modello impari a svolgere il suo compito correttamente.
La raccolta dei dati è una delle fasi cruciali per la creazione di un buon modello e può essere molto complessa, per questo ti consigliamo di leggere l’articolo dedicato.
In questo assumiamo di avere un dataset quasi pronto all’uso e vedremo solo una parte delle operazioni da fare sui dati, in modo molto semplificato. Tuttavia nei casi reali il dataset non è immediatamente utilizzabile e richiede una fase di esplorazione per identificare le necessarie elaborazioni successive
Nel nostro esempio il dataset è rappresentato nella tabella sottostante. Si può notare come per ogni studente conosciamo sia il numero di ore studiate per preparare l’esame (la nostra feature), sia l’esito dell’esame (outcome). Grazie alla presenza di quest’ultimo possiamo dire che ci troviamo di fronte ad un problema di Supervised Learning, in particolare di classificazione perché la variabile ‘esito’ può assumere solo due valori.
Come si può vedere ci possono essere casi estremi come lo studente 1, che è stato promosso studiando un numero limitato di ore. Al contrario lo studente 9 è stato bocciato nonostante abbia dedicato molto tempo alla preparazione dell’esame. Questi casi rendono ancora più complesso l’apprendimento da parte del modello.
| Studente # | Numero Ore | Esito |
|---|---|---|
| 1 | 36 | Promosso |
| 2 | 50 | Bocciato |
| 3 | 90 | Promosso |
| 4 | 62 | Bocciato |
| 5 | 120 | Promosso |
| 6 | 87 | Promosso |
| 7 | 32 | Bocciato |
| 8 | 46 | Bocciato |
| 9 | 106 | Bocciato |
| 10 | 134 | Promosso |
* valori generati casualmente, noi consigliamo di studiare di più 🤣
Step 1 – Encoding
Una volta preso il dataset, il primo step è quello di convertire i valori letterari in valori numerici, perché i computer se la cavano molto meglio quando hanno a che fare coi numeri. Questo processo è noto come feature encoding ed è così importante da avergli dedicato un articolo a parte.
Tornando a noi, nel nostro caso è sufficiente assegnare il valore ‘0’ alla categoria ‘bocciato’ e il valore ‘1’ alla categoria promosso e i dati saranno pronti per essere dati in pasto al modello.
Step 2 – Splitting
Il secondo passaggio che dobbiamo fare è quello di dividerlo in 3 gruppi:
- Training Data: dati usati per addestrare il modello.
- Validation Data: dati utilizzati per regolare i parametri del modello durante l’addestramento.
- Test Data: dati utilizzati per valutare le prestazioni finali del modello dopo l’addestramento.
Se vuoi scoprire meglio le motivazioni dietro a questa divisione ti rimandiamo all’articolo dedicato.
Nel nostro caso, per pulizia del contenuto supponiamo che quello riportato in tabella sia già il dataset di allenamento (training data).
Il Modello – Linear Regression
Un modello di ML può essere visto come una funzione matematica che prende in input uno o più valori numerici ‘X‘ (features) e dei parametri ‘θ’, anch’essi dei valori numerici. In uscita invece restituisce un valore ‘Y’ (outcome).
Per i meno tecnici, una funzione può essere vista come una scatola dentro la quale entrano due oggetti (‘X‘ e ‘θ’) e fuoriesce un nuovo oggetto ‘Y’.
Nel nostro caso vedremo il modello più semplice tra quelli comunemente usati, la Linear Regression.
Si noti che questo è un modello di regressione, pertanto poco adatto a problemi di classificazione come quello che stiamo affrontando. Tuttavia la sua semplicità si presta benissimo a fini didattici.
La Formula
La formula della Linear Regression è la seguente:
I suoi elementi sono:
- y: rappresenta la variabile dipendente predetta (o stimata).
- β0: è l’intercetta della retta di regressione, rappresenta il valore di y quando x è zero.
- β1: è il coefficiente angolare, che indica di quanto varia y per una variazione unitaria in x.
- x: rappresenta la variabile indipendente (o feature) su cui si basa la predizione.
Il simbolo ‘^‘ (hat) sopra la y sta ad indicare che quel valore è quello predetto dal modello e può differire dal valore reale, il quale viene rappresentato senza ‘^‘.
Allenamento del Modello
Siamo arrivati alla parte più interessante, ora scopriremo cosa avviene all’interno del modello e come fa ad imparare in autonomia dai nostri dati.
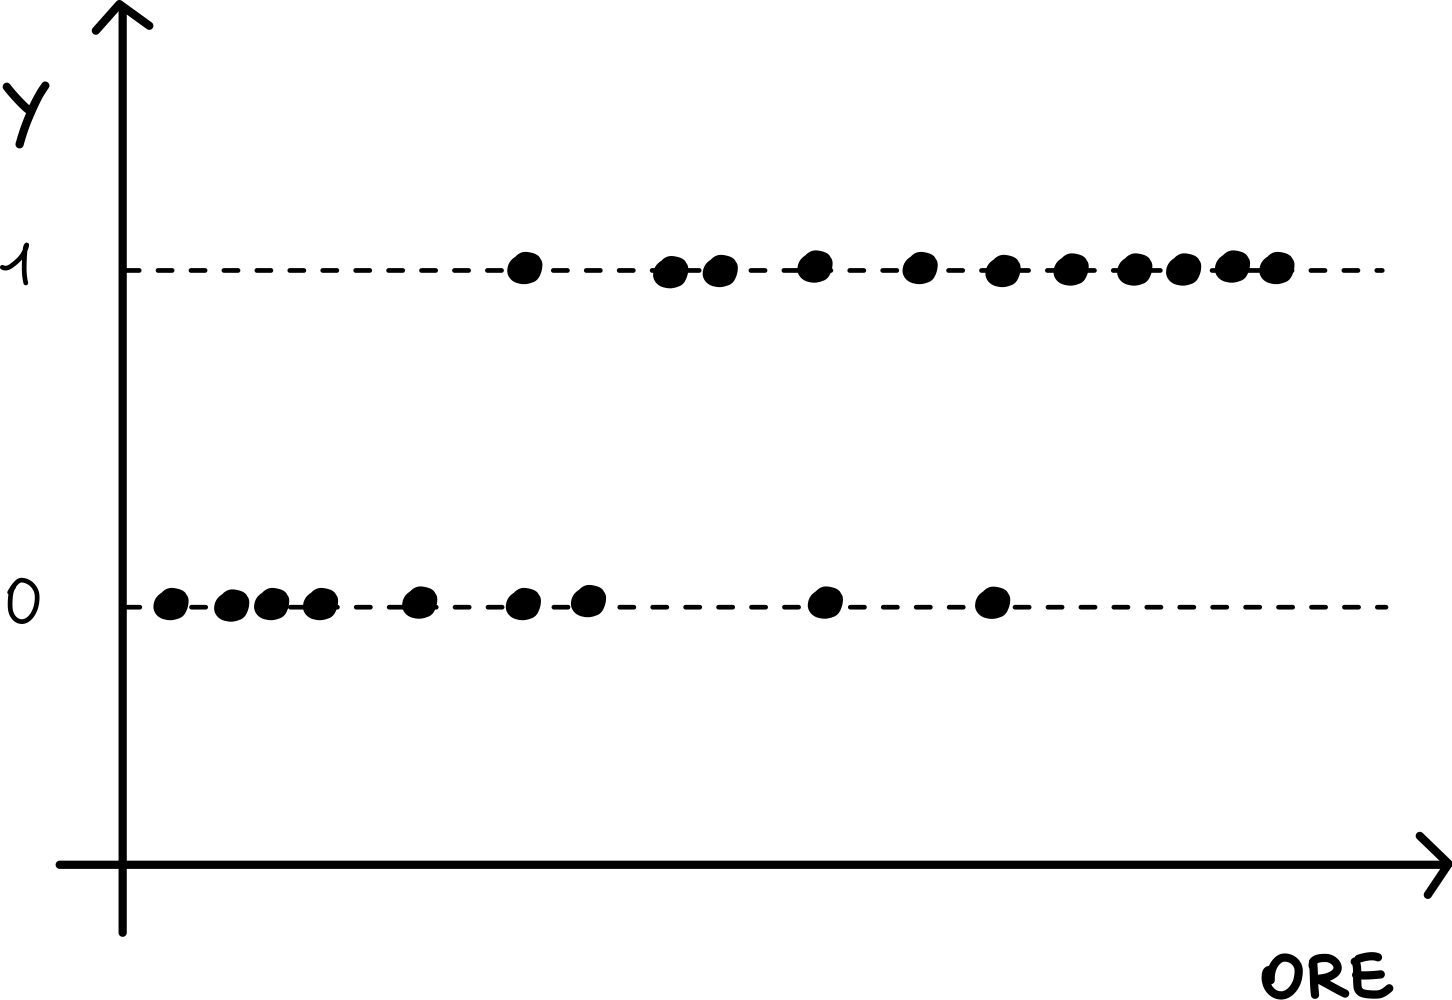
In figura sono stati riportati i dati presenti nella tabella che abbiamo visto sopra. Ogni punto è quindi formato da due valori [ore, esito].
Inizializzazione dei Parametri
A questo punto il modello inizia il suo lavoro assegnando dei valori casuali ai parametri. Si, hai capito bene, i valori iniziali sono scelti ‘a caso’. Supponiamo che i due valori siano β0′ e β1′. La uova equazione diventa quindi:
Prendendo ogni studente, partendo dal primo, il modello inizia a predire un valore per il relativo esito, applicando la formula al numero di ore. Ad esempio per lo studente 1 avremo:
Il valore predetto dal modello è un valore racchiuso nell’intervallo [-ꝏ, ꝏ] ed è classificato nella classe 1 (promosso) se il valore è > 0,5. Viceversa, se il valore è <0,5 lo studente avrà come esito bocciato.
Questo concetto è rappresentato nella figura sotto. Il valore di ore (x) per le quali la retta vale 0,5 è esattamente il punto che discrimina tra un esito positivo dell’esame e uno negativo. Quindi a destra di tale valore di x (ore minime) tutti i valori riceveranno esito positivo (area verde). I valori a sinistra riceveranno invece esito negativo (area rossa).
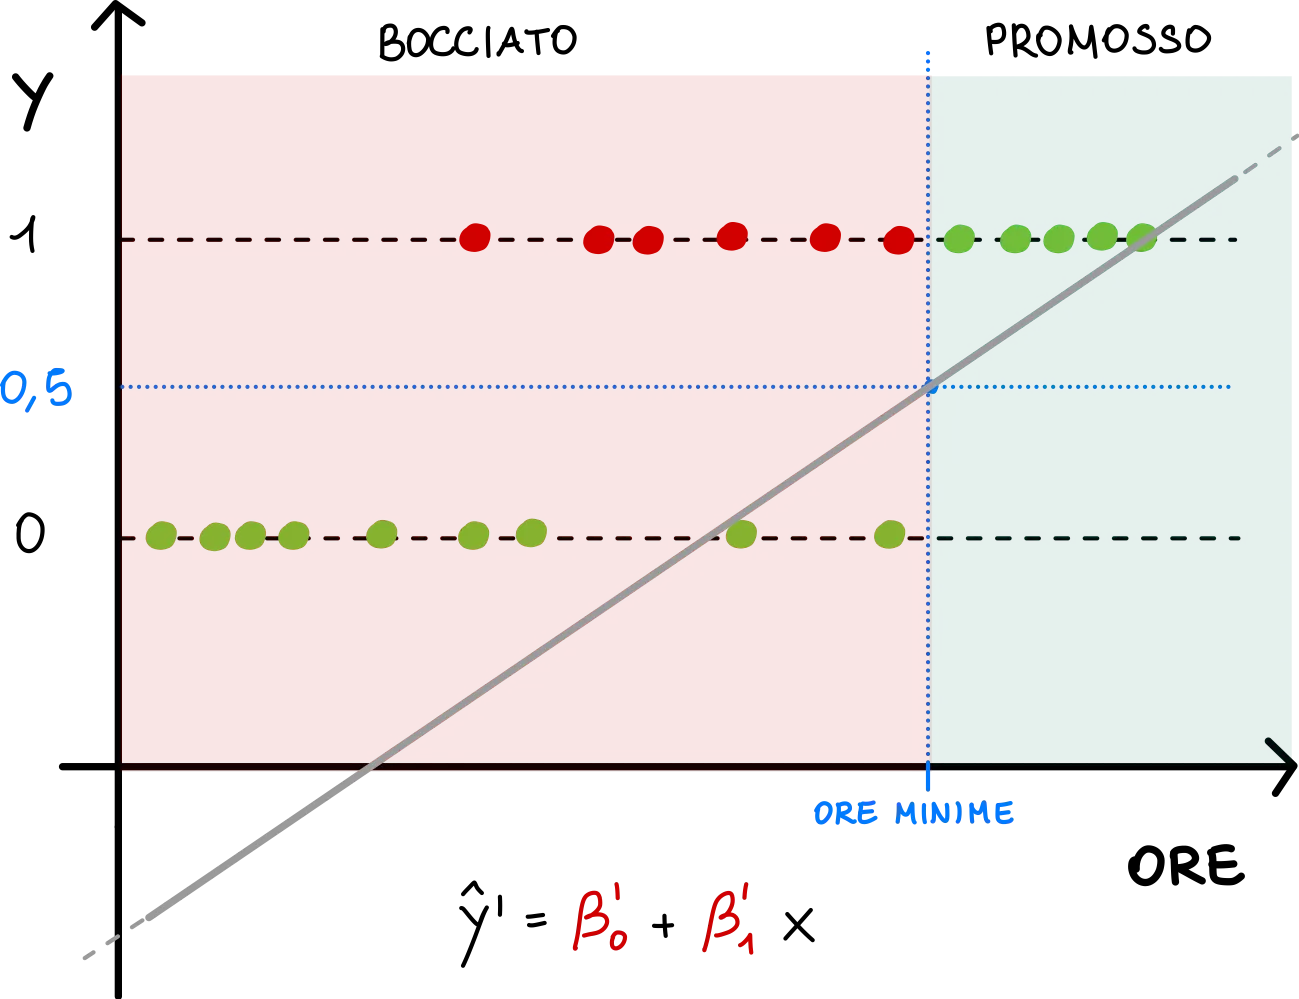
Il colore dei punti indica invece la presenza di un errore sulla classificazione di quel dato da parte del modello. Prendendo come esempio il punto rosso più vicino all’asse y, vediamo che questo giace sulla linea 1, ma allo stesso tempo si trova a sinistra del valore ‘ore minime‘. Questo significa che lo studente ha passato l’esame nella realtà ma il modello sta dando un esito negativo.
Ottimizzazione dei Parametri
A questo punto il modello deve capire se il valore di un parametro va aumentato o diminuito. Per farlo guarda alla cosiddetta loss function (funzione di perdita). Nel caso della linear regression questa funzione si chiama RSS (Residual Sum of Squares) e la formula è riportata di seguito.
Questa funzione compara per ognuno ‘i‘ degli ‘n‘ studenti il valore predetto dal modello ‘y^i‘con il valore reale presente nel training set ‘yi‘ . Così facendo restituisce una misura dell’errore (perdita) che i parametri usati stanno causando. Guardando a questo valore il modello è in grado di capire la variazione da effettuare su ogni singolo parametro.
Per comprendere meglio guardiamo alla figura sotto. La RSS ha una forma a parabola e ogni valore del parametro in x corrisponde ad una perdita. Il modello non deve fare altro che usare delle tecniche matematiche di minimizzazione che consentiranno di trovare il valore in sull’asse x per il quale la loss è minimizzata.
Il funzionamento di queste tecniche è un aspetto più complesso, seppur non troppo ed esula dallo scopo di questo articolo. Se sei curioso e vuoi approfondirlo abbiamo un articolo anche per questo.
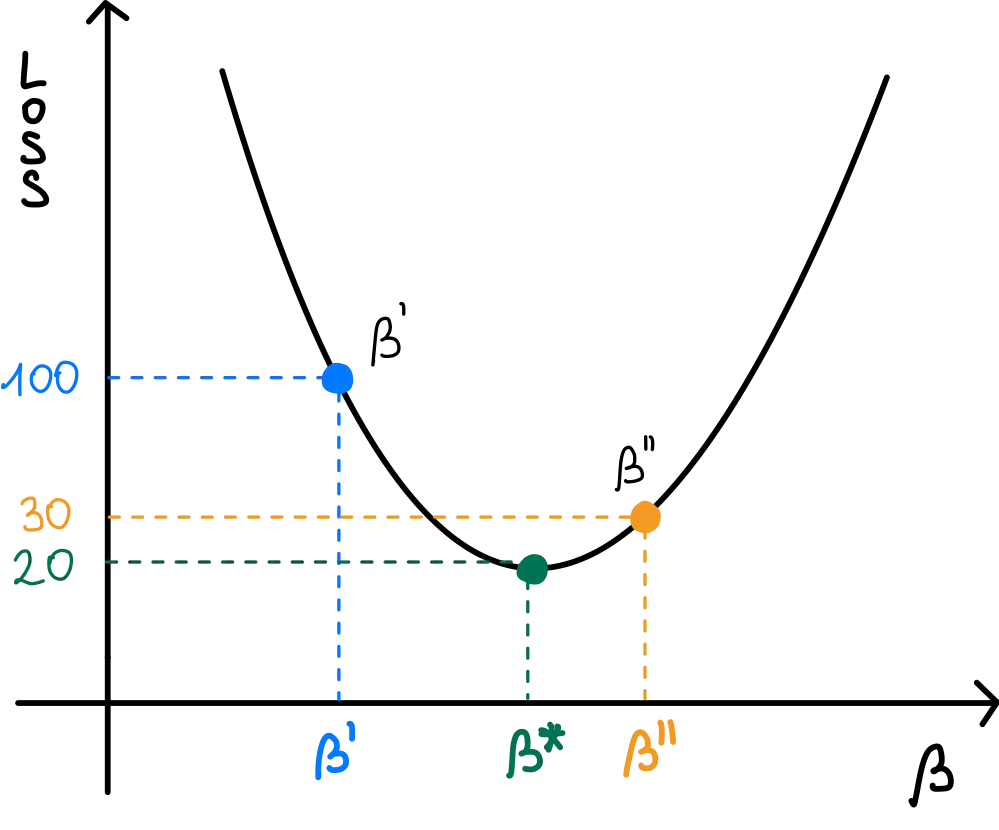
Per il momento tutto ciò che ci interessa sapere è che la minimizzazione è iterativa, ovvero avviene in diversi step successivi nella maggior parte dei casi.
Un’eccezione è proprio rappresentata dalla RSS, in quanto può essere minimizzata in un colpo solo (analiticamente). Tuttavia visto che nulla vieta una sua ottimizzazione iterativa, assumiamo di usare questo approccio al fine di mostrare come funziona.
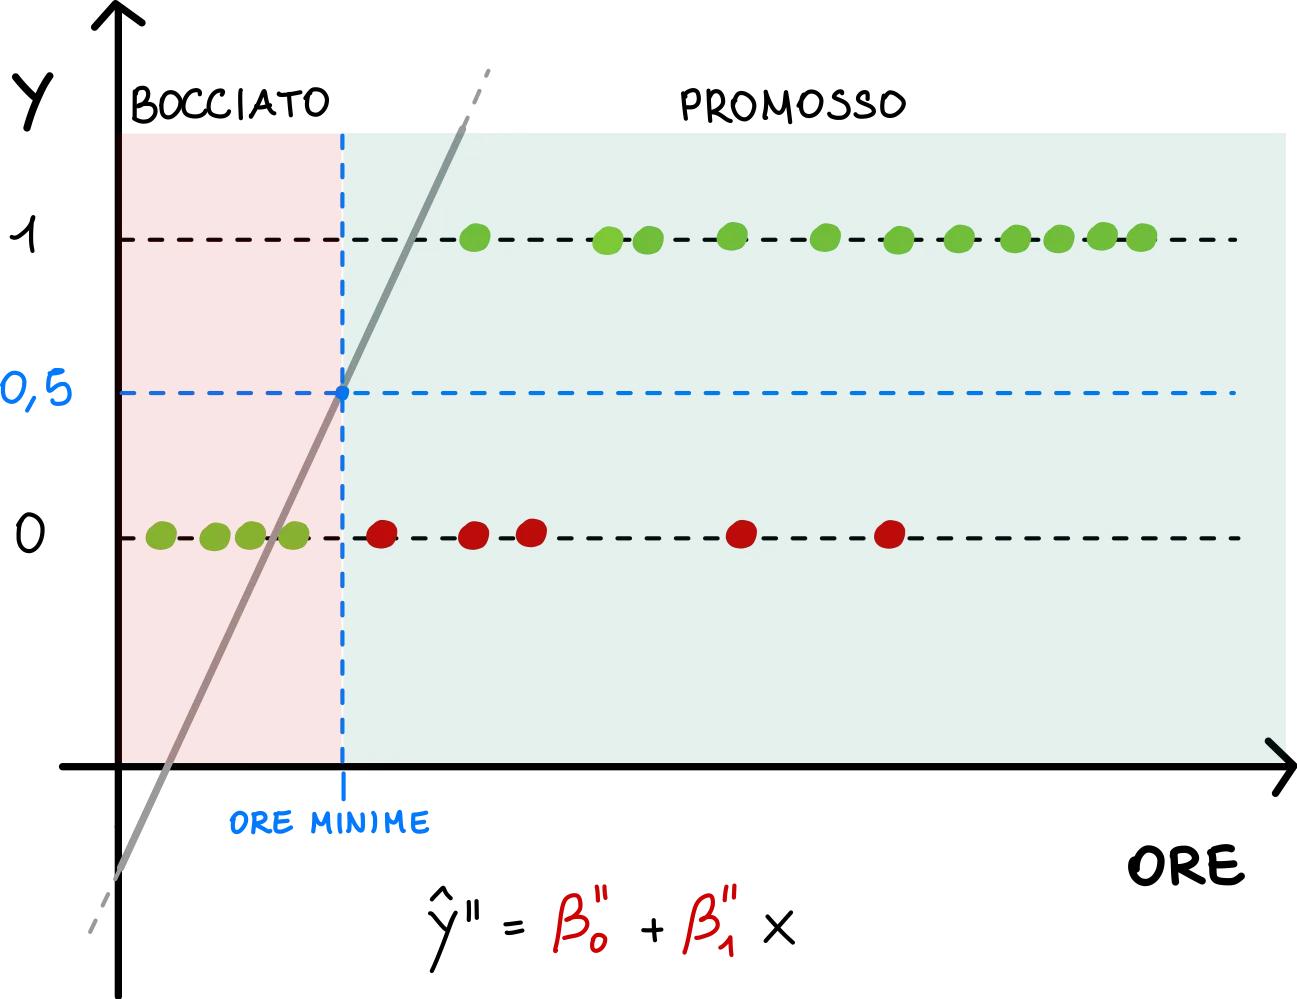
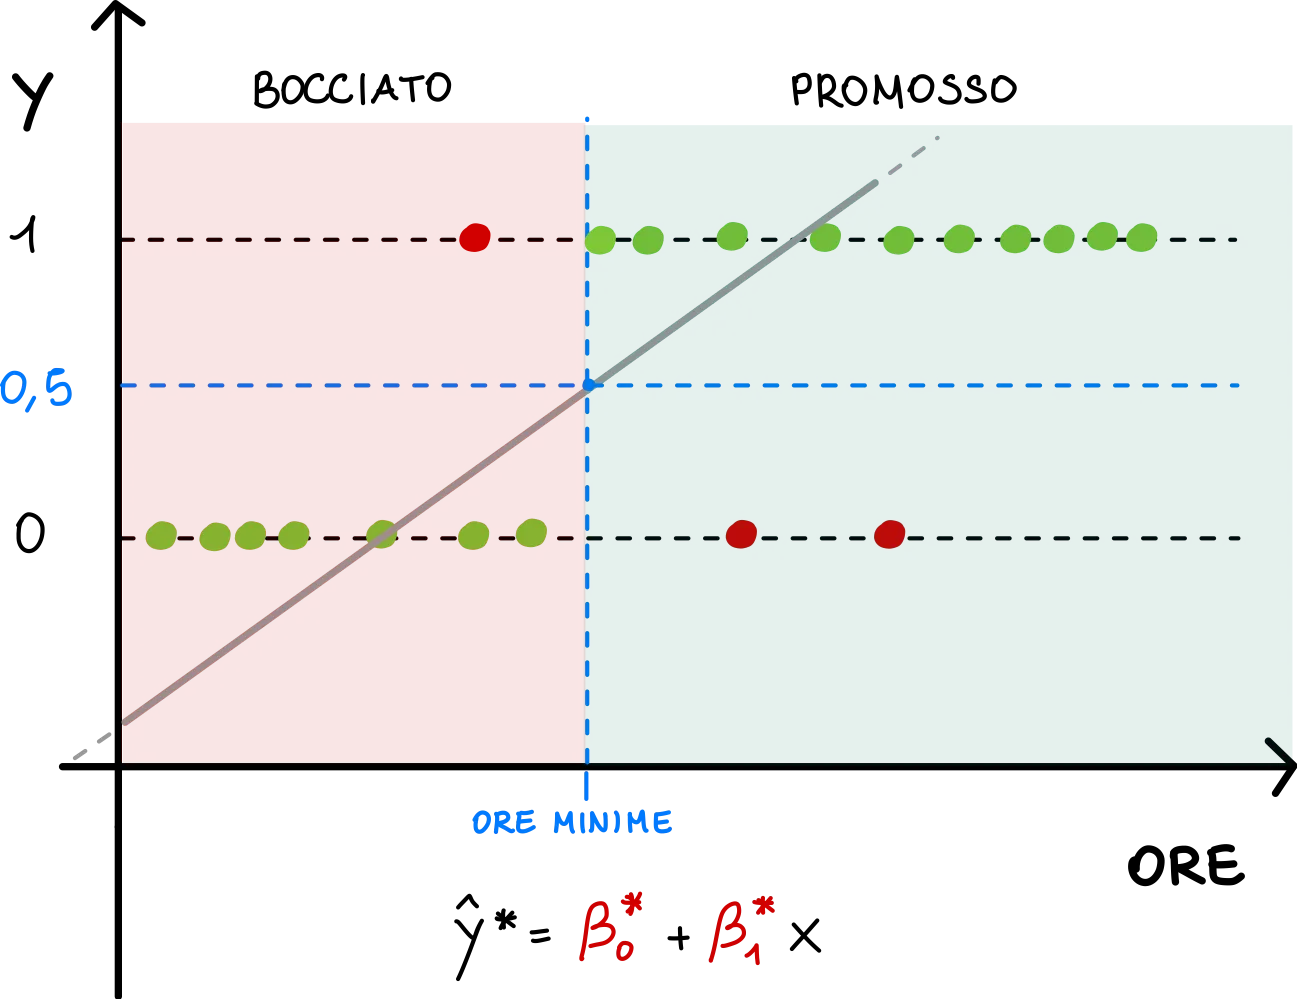
Quello che succede al nostro modello durante la minimizzazione è che i valori dei parametri iniziano a cambiare (formula in figura) e il numero di errori inizia a ridursi.
Nella figura sotto vediamo che la retta ha cambiato la sua inclinazione e ora quelli che prima erano errori sono stati corretti. Per contro altri punti che prima erano classificati correttamente sono ora diventati errori.
Ora si ripete nuovamente ciò che abbiamo appena visto:
- La nuova perdita viene calcolata
- I parametri vengono aggiornati nella direzione corretta
- I punti vengono classificati dal nuovo modello
Alla fine di tutto il modello convergerà al valore ottimo dei parametri (β0* e β1*), ovvero quel valore che consente di ridurre al minimo l’errore. Dalla figura si vede infatti che il numero di pallini rossi è diminuito.
Fare Inferenza
Il nostro modello è finalmente allenato. Ha imparato tutto ciò che poteva imparare dai dati che gli abbiamo fornito e sei pronto per scoprire se supererai o meno l’esame.
Tutto ciò che devi fare è inserire nel modello il numero di ore che hai dedicato allo studio e lui ti dirà se sei pronto o meno.
Questa fase si chiama in gergo tecnico inferenza, perchè partendo da un valore iniziale stiamo prevedendo (inferendo) un valore che prima non conoscevamo.


