
Hai sentito spesso parlare di allenamento di un modello di machine learning o intelligenza artificiale e ti sei chiesto cosa significa? Vuoi capire come fa un modello ad imparare semplificando i formalismi matematici? Questo articolo è quello che fa per te.

Conoscenze preliminari
Il contenuto di questo articolo richiede la conoscenza di cos’è un modello di machine learning e un’idea generale del processo di allenamento e dei suoi elementi principali. Se non hai ben chiari questi concetti, ne abbiamo parlato in modo intuitivo: Il Supervised Machine Learning spiegato semplice
Introduzione
In questo articolo andremo ad approfondire a livello concettuale i 3 elementi fondamentali dell’allenamento:
- Inizializzazione dei parametri
- Loss functions (funzioni di perdita)
- Algoritmi di ottimizzazione
Nota: i contenuti di questo articolo sono specifici per Machine Learning (ML) e Deep Learning (ML) nel caso supervised, la tipologia più comune e diffusa ad oggi.
Ad onor del vero, seppur i concetti di base sono esattamente gli stessi, il DL richiede qualche accorgimento in più e gli abbiamo dedicato un articolo apposito.
Inizializzazione dei Parametri
Come un buon personal trainer, una corretta inizializzazione dei parametri assicura che il tuo modello inizi il suo allenamento con i giusti presupposti, per raggiungere la massima forza e flessibilità nei confronti dei dati.
Il processo di ottimizzazione, come vedremo più avanti, si basa sul confronto tra valore predetto dal modello e valore reale di ogni campione. Per predire un valore, il modello ha quindi bisogno di attribuire dei valori iniziali ai propri parametri (indicati con ‘β‘ nella formula della Binary Logistic Regression sottostante).
Questa fase, detta inizializzazione dei parametri è cruciale, poiché definisce lo stato iniziale del modello prima che inizi il processo di apprendimento. La scelta dell’inizializzazione può influenzare notevolmente se il modello raggiungerà efficacemente il punto di minimo della funzione di costo o meno.
Nel contesto del machine learning tradizionale, dove le funzioni di costo sono spesso convesse e gli algoritmi relativamente semplici, l’inizializzazione casuale dei parametri è generalmente sufficiente. Tuttavia, nel caso del deep learning, l’inizializzazione casuale potrebbe non essere sufficiente a causa della complessità delle architetture neurali. Per questo sono state sviluppate tecniche più sofisticate, come Xavier e He. Per approfondire il deep learning rimandiamo all’articolo linkato nel riquadro verde.
Loss Functions
La funzione di perdita è come un allenatore di fitness per il tuo modello, che lo spinge a sudare e a perdere ‘peso‘ fino a raggiungere la forma migliore per affrontare le sfide dei dati.
Indipendenti e Identicamente Distribuiti (IID)
Le funzioni di perdita considerano spesso i dati come indipendenti e identicamente distribuiti (IID). Questo significa che ogni osservazione nel dataset viene trattata come estratta dalla stessa distribuzione di probabilità, e che le osservazioni sono indipendenti l’una dall’altra. Questa assunzione semplifica l’analisi e la costruzione dei modelli, ma comporta l’inevitabile introduzione di errori.
Questo tema è più tecnico e non è affrontato in questo articolo, ma è fondamentale essere consapevoli di questa caratteristica.
Scopo
Con i parametri inizializzati, il modello è pronto per fare previsioni sui dati. Tuttavia, è fondamentale avere uno strumento che permetta al modello di valutare la bontà delle sue previsioni e comprendere in che misura si discostano dai valori attesi. Questo compito è affidato alla Loss Function (funzione di perdita).
Esempio pratico: binary cross entropy
Vediamo a livello pratico come funziona una loss function, prendendo ad esempio une delle più usate in assoluto, la Binary Cross Entropy. Questa è usata per problemi di classificazione binaria, dove le variabili yi e y^i assumono ciascuna solo due valori, 0 o 1.
Dove:
- è il numero di osservazioni nel dataset.
- è il valore reale dell’osservazione ‘i’, quindi 0 o 1.
- è il valore predetto dal modello per l’osservazione ‘i’, anche questo 0 o 1.
Dimentichiamo la sommatoria e concentriamoci sulla sola parte tra parentesi quadre. Qui abbiamo due addendi: e .
- : questo addendo vale 0 quando la classe reale è 0 e vale quando la classe reale è 1.
- : questo vale 0 se la classe del punto ‘i’ è 1, vale se .
Possiamo quindi dividere la funzione di perdita in due parti: CEpos () e CEneg ().
Parte 1: campioni di classe positiva
Questo caso rappresenta la perdita per tutti i punti della classe 1. Quindi si prende il punto ‘i’ e si calcola il valore della sua perdita applicando il logaritmo al valore predetto dal modello per tale punto. Se il valore predetto è 1 l’impatto sulla perdita sarà nullo, infatti log(1) = 0, se invece il valore predetto è diverso, ad esempio 0.3, il valore della perdita sarà log(0.3).
Lo stesso procedimento viene ripetuto per tutti i punti del training set e le relative perdite sono sommate, come indicato dalla sommatoria.
Parte 2: campioni di classe negativa
In questo caso viene fatto lo stesso per ogni campione negativo. Pertanto, se il valore predetto è 0 l’impatto sulla perdita sarà log(1 - 0) = 0, quindi nullo. Viceversa avremo un valore diverso da 0.
CE totale
Alla fine quindi la CE è assegna un valore di perdita ad ogni campione erroneamente classificato dal nostro modello. La somma di questi valori è la nostra perdita totale sulla quale lavorano gli algoritmi di ottimizzazione.
Nota: se sei interessato ad un esempio numerico riguardo alla cross entropy e a precisazioni matematiche che la spieghino meglio, clicca qui.
Tipologie
I problemi di machine learning, come la classificazione e la regressione, richiedono approcci differenti per la valutazione delle prestazioni del modello. Di conseguenza, sono utilizzate diverse tipologie di funzioni di perdita, progettate per adattarsi alle specifiche esigenze di ciascun tipo di problema.
In questa sezione vengono elencate alcune loss functions tra le più usate, semplicemente per portarle a conoscenza del lettore. Una loro analisi verrà fatta a tempo debito con articoli appositi, che saranno disponibili nella sezione 5 del flusso di creazione di un modello.
Mostra legenda formule
Legenda Formule:
- è il numero di osservazioni nel dataset.
- sono i valori effettivi.
- sono i valori predetti dal modello.
- è il numero di classi nel problema di classificazione multiclasse.
- è l’indicatore della classe reale per l’osservazione .
- è la probabilità predetta per l’osservazione appartenente alla classe .
- è il coefficiente di regolarizzazione.
Regressione
Mostra formule regressione
MSE: Errore Quadratico Medio
- Descrizione: Misura la media dei quadrati delle differenze tra i valori predetti e i valori effettivi.
- Limiti: Sensibile agli outliers in quanto la differenza è ampliata dal quadrato.
MAE: Errore Assoluto Medio
- Descrizione: Misura la media delle differenze assolute tra i valori predetti e i valori effettivi.
- Limiti: Gli errori grandi hanno lo stesso peso degli errori piccoli a causa della mancanza del termine quadratico.
MAPE: Errore Percentuale Assoluto Medio
- Descrizione: Misura l’errore percentuale medio tra i valori predetti e i valori effettivi.
- Limiti: Può causare problemi se i valori effettivi sono molto vicini a zero, poiché il denominatore diventa molto piccolo e può portare a divisioni per zero o a valori instabili.
Classificazione
Mostra formule classificazione
Cross-Entropy Loss (Binary):
- Descrizione: Misura la discrepanza tra la distribuzione delle probabilità predette e la distribuzione delle probabilità reali in problemi di classificazione binaria.
- Algoritmi: Algoritmi di classificazione binaria (ex. reti neurali, logistic regression).
Cross-Entropy Loss (Multiclass):
- Descrizione: Misura la discrepanza tra la distribuzione delle probabilità predette e la distribuzione delle probabilità reali in problemi di classificazione multiclasse.
- Algoritmi: Algoritmi di classificazione mutilasse (ex. reti neurali, logistic regression).
Hinge Loss (SVM):
- Descrizione: Misura la penalità associata alla classificazione errata di un campione, valutando la distanza tra la previsione del modello e il valore reale attraverso la funzione di margine. Penalizza maggiormente le previsioni errate che si trovano al di fuori del margine stabilito, mentre non penalizza quelle corrette o all’interno del margine.
- Algoritmi: Support Vector Machine (SVM).
Costruzione tramite likelihood
Molto belle tutte queste funzioni di perdita, ma chi le ha inventate? Perchè sono fatte esattamente così? Se ti sei mai posto queste domande, sappi che esiste una risposta: la likelihood.
Alla base della maggior parte delle funzioni di perdita c’è la volontà di massimizzare la probabilità che il nostro modello, con il valore dei suoi parametri , restituisca dei dati che siano quanto più possibile simili a quelli di allenamento. Il tutto è espresso dalla seguente formula.
Questa parte è un pò più tecnica e esula dallo scopo di questo articolo, ma puoi trovarla qui.
Regolarizzazione
La regolarizzazione è un concetto chiave nell’allenamento dei modelli, utilizzato per prevenire l’overfitting e migliorare la generalizzazione del modello. È spesso incorporata direttamente nelle funzioni di perdita attraverso l’aggiunta di termini di regolarizzazione.
Se vuoi scoprire di più sulla prevenzione dell’overfitting tramite regolarizzazione ti rimandiamo all’articolo dedicato. In questo ci limitiamo a mostrare come questa venga implementata in una loss function. Esistono essenzialmente due tipi di regolarizzazione nel machine learning tradizionale, chiamati L1 e L2.
Vedi formule e descrizione
Ridge Regression (L2):
- Descrizione: Aggiunge un termine di regolarizzazione basato sul quadrato dei parametri alla funzione di perdita. Consente di ridurre fortemente il valore dei certi parametri e di ridurre la complessità del modello per prevenire l’overfitting.
Lasso Regression (L1):
- Descrizione: Aggiunge un termine di regolarizzazione basato sul modulo dei parametri alla funzione di perdita. Consente di annullare totalmente certi parametri e di ottenere modelli sparsi.
Funzionamento
L’idea è molto semplice e consiste nel sommare alla nostra loss un valore che dipende dai parametri. Nel caso della binary cross entropy con regolarizzazione L2 avremo:
In questo modo quando il nostro modello ha molti parametri con valore elevato, subirà una perdita maggiore. Ciò spinge il modello a trovare un equilibrio tra l’accuratezza di classificazione e la complessità del modello, con l’obiettivo di ridurre la magnitudine dei parametri.
Durante l’addestramento, i parametri vengono regolati in modo tale da ridurre la penalità complessiva, con un focus particolare sulla riduzione dei parametri che contribuiscono meno all’accuratezza del modello. In pratica, se un parametro influente viene ridotto, la perdita associata all’accuratezza di classificazione aumenta, incoraggiando il modello a mantenere tale parametro intatto. Al contrario, i parametri meno influenti possono essere ridotti con minori conseguenze sulla perdita complessiva, favorendo una maggiore semplicità del modello.
Alla fine del processo di addestramento, otterremo un equilibrio ottimale tra la complessità del modello e la sua capacità di generalizzazione. Questo significa trovare il giusto compromesso tra un modello complesso e flessibile, che potrebbe rischiare di sovradattarsi ai dati di addestramento, e un modello troppo semplice, che potrebbe non essere in grado di catturare abbastanza informazioni dai dati.
Hai dei dubbi riguardo ai concetti di overfitting e regolarizzazione? Vista la loro importanza stiamo lavorando ad un articolo apposito che sarà consultabile cliccando qui.
Algoritmi di Ottimizzazione
Se la funzione di perdita è l’allenatore personale del tuo modello, gli algoritmi di ottimizzazione sono come una varietà di attrezzi da palestra. Ognuno offre un modo diverso per plasmare e scolpire i pesi (parametri) del tuo modello.
Scopo
Abbiamo visto che la loss function misura l’errore commesso dal modello. Ora abbiamo bisogno di qualcosa che capisca come ridurre tale errore. In altre parole abbiamo bisogno di un algoritmo che consigli al modello come variare i parametri in modo tale da ridurre la perdita.
Ci sono due modi principali per ottimizzare: uno è più diretto, risolvendo equazioni, utile per problemi semplici come la regressione lineare. In questo caso il valore ottimo dei parametri è la soluzione dell’equazione o sistema di equazioni.
Tuttavia, in molti casi in cui le equazioni non bastano e si passa agli approcci iterativi. In questo approccio il valore dei parametri viene approssimato ad ogni iterazione, avvicinandosi progressivamente alla soluzione. Non sempre la reale soluzione ottima viene raggiunta, ma si cerca di avvicinare il suo valore il più possibile. Questi sono gli algoritmi più comuni nel Machine Learning, su cui questa sezione si focalizza.
Algoritmi iterativi: ragionamento alla base
Gli algoritmi di ottimizzazione iterativi sono processi che si sviluppano in step successivi, basati sul calcolo del gradiente. Ad ogni passaggio, valutano la pendenza della funzione di perdita in un punto specifico e si spostano nella direzione opposta per ridurre l’errore. Questo ciclo si ripete fino a che non si soddisfa un criterio di terminazione. Tipicamente, ciò avviene quando la differenza tra i valori di perdita tra due iterazioni successive è inferiore a una soglia predefinita, o quando viene raggiunto un numero massimo di iterazioni. Alla fine del processo, i parametri assumeranno valori tali per cui il modello è in grado di fare previsioni migliori, poiché si avvicinano al punto di minimo della loss.
Questo meccanismo funziona perfettamente quando abbiamo a che fare con funzioni convesse come quella in figura.
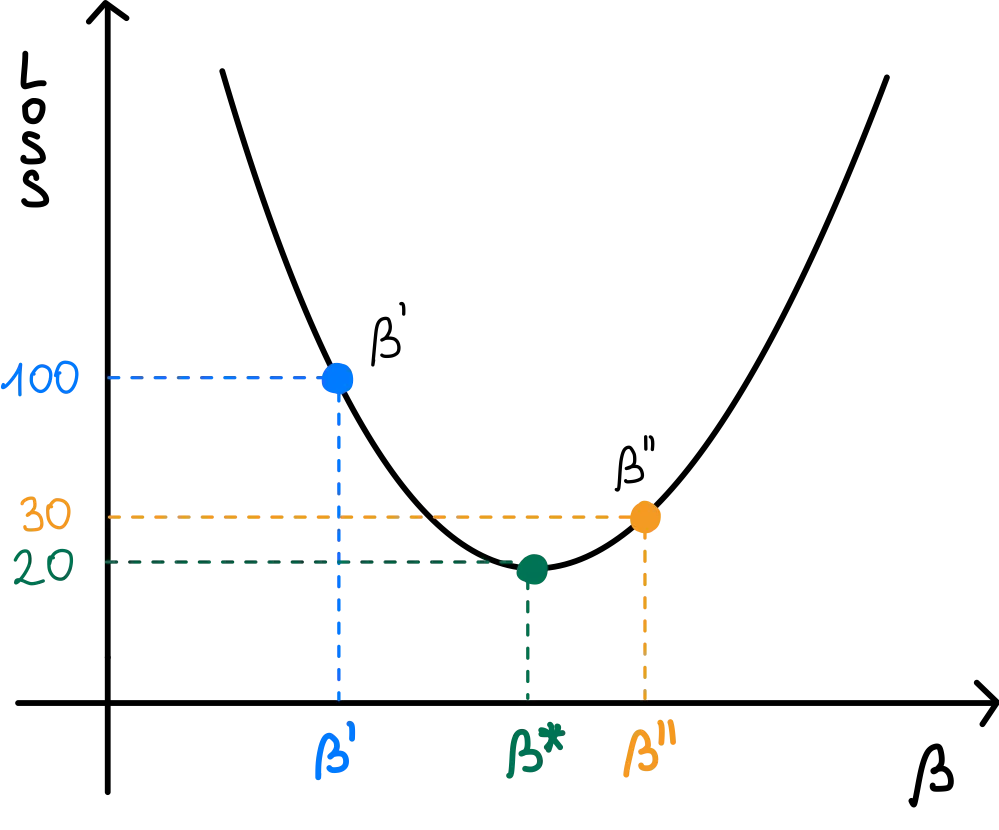
Se i nostri parametri sono quelli blu, la pendenza (derivata) viene calcolata nel punto (β‘, 100) e in questo caso risulterebbe negativa. I parametri verranno quindi aumentati, nella direzione del punto di minimo. Se con questo aumento i nuovi parametri sono quelli arancio, allora la derivata nel punto (β”, 30) sarà positiva e quindi i parametri verranno ridotti, muovendosi verso sinistra, nuovamente verso il punto di minimo, che in questo caso viene esattamente raggiunto.
Tipologie
Legenda Formule:
- θ rappresenta i parametri del modello,
- α è il tasso di apprendimento,
- J(θ) è la funzione di perdita,
- ∇J(θ) è il gradiente della funzione di perdita rispetto ai parametri,
- B è un mini batch di dati, e
- è un singolo punto del training set.
Gradient Descent (GD):
GD è un processo iterativo che, ad ogni passaggio, calcola la loss per ogni punto del training dataset, quindi calcola la derivata della loss e aggiorna i parametri nella direzione opposta. La formula di aggiornamento dei parametri è la seguente:
GD produce una diminuzione progressiva e stabile della loss, poiché la direzione presa è corretta, in quanto basato sul contributo dell’intero training set. Questo, per contro, comporta molta complessità computazionale.
Mini Batch Gradient Descent (MBGD):
MBGD è simile a GD, ma considera solo un sottoinsieme (batch) dei punti del training set ad ogni iterazione. Questo porta a una maggiore efficienza computazionale, ma potrebbe rendere la loss leggermente più instabile. La scelta della dimensione del batch è cruciale.
Stochastic Gradient Descent (SGD):
SGD estremizza la riduzione dei punti considerati ad ogni iterazione, focalizzandosi su un solo punto alla volta. Questo approccio rende la loss più instabile, poiché basare gli aggiornamenti solo su un singolo punto potrebbe non essere sempre corretto. Tuttavia, se eseguito per un numero sufficiente di iterazioni, la direzione complessiva degli aggiornamenti sarà in media corretta. Questo conferisce allo SGD una grandissima efficienza computazionale.
Hai dubbi sul funzionamento degli algoritmi di ottimizzazione o vuoi approfondire l’argomento? Stiamo lavorando ad un articolo solo per questo, che sarà disponibile a questo link.
Limitazioni
Questi algoritmi possono riscontrare difficoltà quando la funzione di perdita non è convessa, situazione comune nei problemi di deep learning. Per affrontare questa sfida, sono state introdotte tecniche speciali come il momentum, che non sono trattate in questo articolo. Inoltre, nel contesto del deep learning, sono state sviluppate tecniche più sofisticate come Adam, progettate per gestire l’elevata complessità delle architetture neurali.


